Я нашел ошибку в Scout, которая на первый взгляд выглядела как небольшая ошибка классификации. Ассистента спросили: Задокументирован ли LeetCode как пробел? База знаний явно содержала эту связь. У модели было достаточно доказательств, чтобы ответить...
Я нашел ошибку в Scout, которая на первый взгляд выглядела как небольшая ошибка классификации.
Ассистента спросили:
Задокументирован ли LeetCode как пробел?
База знаний явно содержала эту связь. У модели было достаточно доказательств, чтобы ответить утвердительно. Сгенерированный ответ может быть даже семантически правильным.
Система по-прежнему рассматривала запрос как другой вопрос:
Знает ли Брэдли LeetCode?
В этом различии и заключается вся история.
Разведчик потерпел неудачу не потому, что ему не хватало факта. Это не удалось, потому что факт был прикреплен к неправильному предложению где-то между предложением пользователя и окончательным ответом.
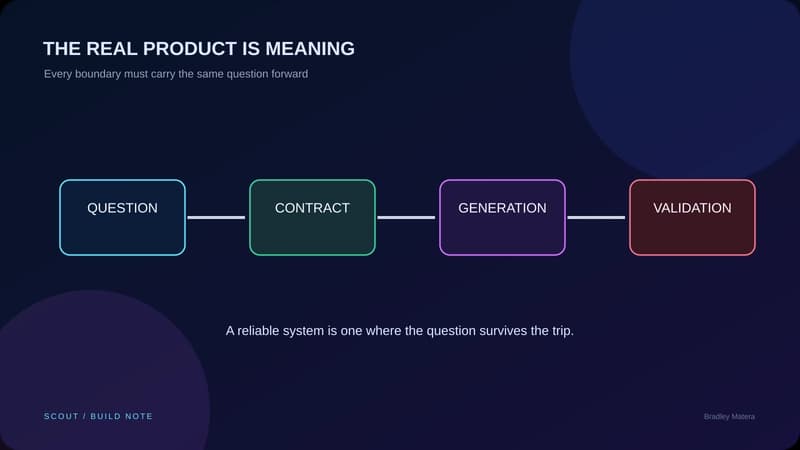
Работа не завершена, когда модель произносит беглое предложение. Исходный вопрос должен пережить всю поездку.
Это следующий этап Scout: не просто извлекать информацию и просить модель сформулировать ее, но и сохранять то, что на самом деле спросил пользователь, достаточно долго, чтобы модель могла ответить на этот вопрос.
Вопрос выглядел простым, потому что сбой был выше по течению.
Граф знаний содержит отношения, эквивалентные:
{
тема: «Брэдли»,
отношение: "has_gap",
объект: «LeetCode»
}
Эти отношения очень ясно подтверждают один ответ:
Да, LeetCode документирован.