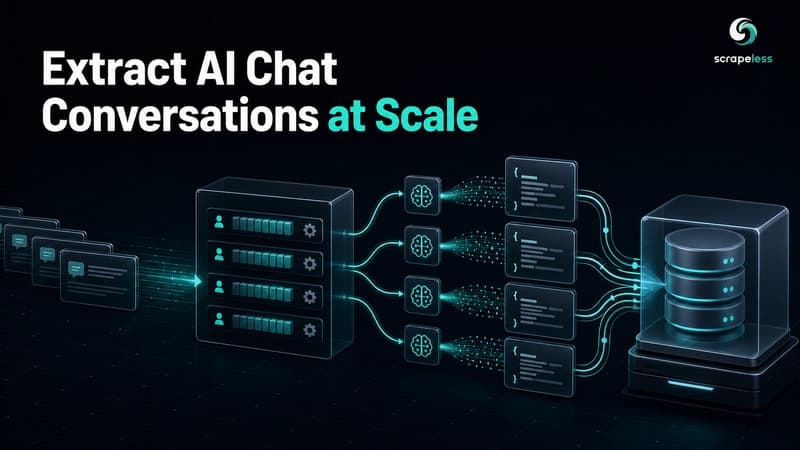
Получение одного ответа ИИ — это вызов API. Сбор полезного набора данных — это конвейер. В масштабе сложные вопросы уходят от синтаксиса HTTP: Как запустить одну и ту же панель подсказок на нескольких поверхностях чата с искусственным интеллектом? Как сохранить сырые продукты...
Получение одного ответа ИИ — это вызов API. Сбор полезного набора данных — это конвейер.
В масштабе сложные вопросы уходят от синтаксиса HTTP:
Как запустить одну и ту же панель подсказок на нескольких поверхностях чата с искусственным интеллектом?
Как сохранить необработанные данные, сохраняя при этом единую схему анализа?
Как сохранить ограниченность параллелизма?
Как вы идентифицируете каждый захват после изменения ответа?
Как добавить новую платформу, не переписывая сборщик?
В этом руководстве создается производственный конвейер Python на основе Scrapeless LLM Chat Scraper. Он охватывает ChatGPT, Perplexity, Gemini, Copilot и Grok через одну конечную точку, сохраняя при этом поля, специфичные для платформы, за небольшими адаптерами.
Архитектура
Трубопровод состоит из четырех этапов:
Планируйте — расширяйте подсказки, страны и механизмы, создавая конкретные задания.
Захват — отправьте каждое задание соответствующему актеру Scrapeless.
Сохранять — запишите нетронутый ответ как запись JSON Lines, доступную только для добавления.
Нормализовать — сопоставить поля ответа и цитаты в одну нисходящую схему.
Не объединяйте эти этапы в одну большую функцию. Необработанный захват и нормализация имеют разные жизненные циклы. Если адаптер изменится, вы сможете восстановить нормализованные данные.