Представьте, что вы создаете ИИ-помощника для компании с тысячами внутренних документов. Сотрудник спрашивает: «Могут ли корпоративные клиенты расторгнуть свои контракты до продления?» Вопрос пользователя не всегда является хорошим поисковым запросом. Подумайте: «В...
Представьте, что вы создаете ИИ-помощника для компании с тысячами внутренних документов. Сотрудник спрашивает: «Могут ли корпоративные клиенты расторгнуть свои контракты до продления?»
Ваша система выполняет поиск в базе данных векторов, извлекает несколько фрагментов, отправляет их в LLM и получает уверенный ответ. Демо работает. Затем кто-то задает тот же вопрос по-другому: «Что произойдет, если крупный клиент захочет уйти до продления контракта?»
Система извлекает другой набор документов. Один — старая ценовая политика, другой обсуждает продления, а третий лишь частично отвечает на вопрос.
LLM по-прежнему дает убедительный ответ. Ничего не разбилось. Ответ просто не имеет достаточной поддержки. В этот момент производственный RAG сильно отличается от демо-версии RAG.
Если бы я сегодня создавал производственную RAG-систему, я бы не остановился на: Vector DB → LLM.
Это хорошая отправная точка для доказательства того, что RAG работает. Для производства я бы хотел что-то ближе к:
Пользователь
↓
API
↓
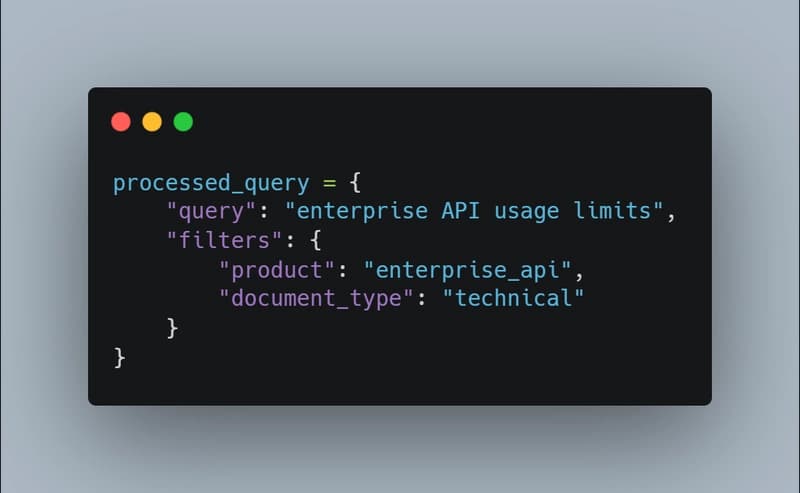
Обработка запросов
↓
Гибридный поиск
↓
Изменение рейтинга
↓
Сжатие контекста
↓
Магистр права
↓
Проверка цитирования
↓
Ответ
Важным моментом является отсутствие восьми отдельных сервисов. Это дает каждому этапу оценку c.